El Govern destinarà 3 milions d'euros a una nova fase del projecte 'AINA', que busca fer possible que les màquines entenguin i parlin en català constituint un conjunt massiu de dades, en col·laboració amb el Barcelona Super Computing Center (BSC). Després d'aconseguir desenvolupar un corpus de text de més de 1.770 milions de paraules reunides en 95 milions de frases, ara el projecte vol crear un diccionari de veu del català. El Departament de Polítiques Digitals llançarà una campanya aquest dimecres per assolir que "milions de veus" parlants de la llengua s'hi sumin, buscant la diversitat de variants, edats, gèneres o orígens per tal d'aconseguir duplicar la base de dades actual de veu en català, que és de 1.000 hores.
El corpus de veu en català es nodrirà dels continguts obtinguts a través de la plataforma de 'Common Voice' de Mozilla, on tothom que ho vulgui podrà llegir i enregistrar un nombre il·limitat de frases per ajudar les màquines a aprendre com parlen les persones.
De moment, el perfil de veu majoritari és la d'homes d'entre 30 i 50 anys parlants de català central. Per això, la campanya 'La nostra llengua és la teva veu' convida la ciutadania de totes les edats, gèneres i procedències a "donar" la seva veu. "La nostra idea és que tinguem parlants de tots els indrets de Catalunya, però també de les Balears i el País Valencià", ha dit el vicepresident del Govern i conseller de Polítiques Digitals, Jordi Puigneró, en una roda de premsa per presentar el projecte, celebrada a la seu del BSC.
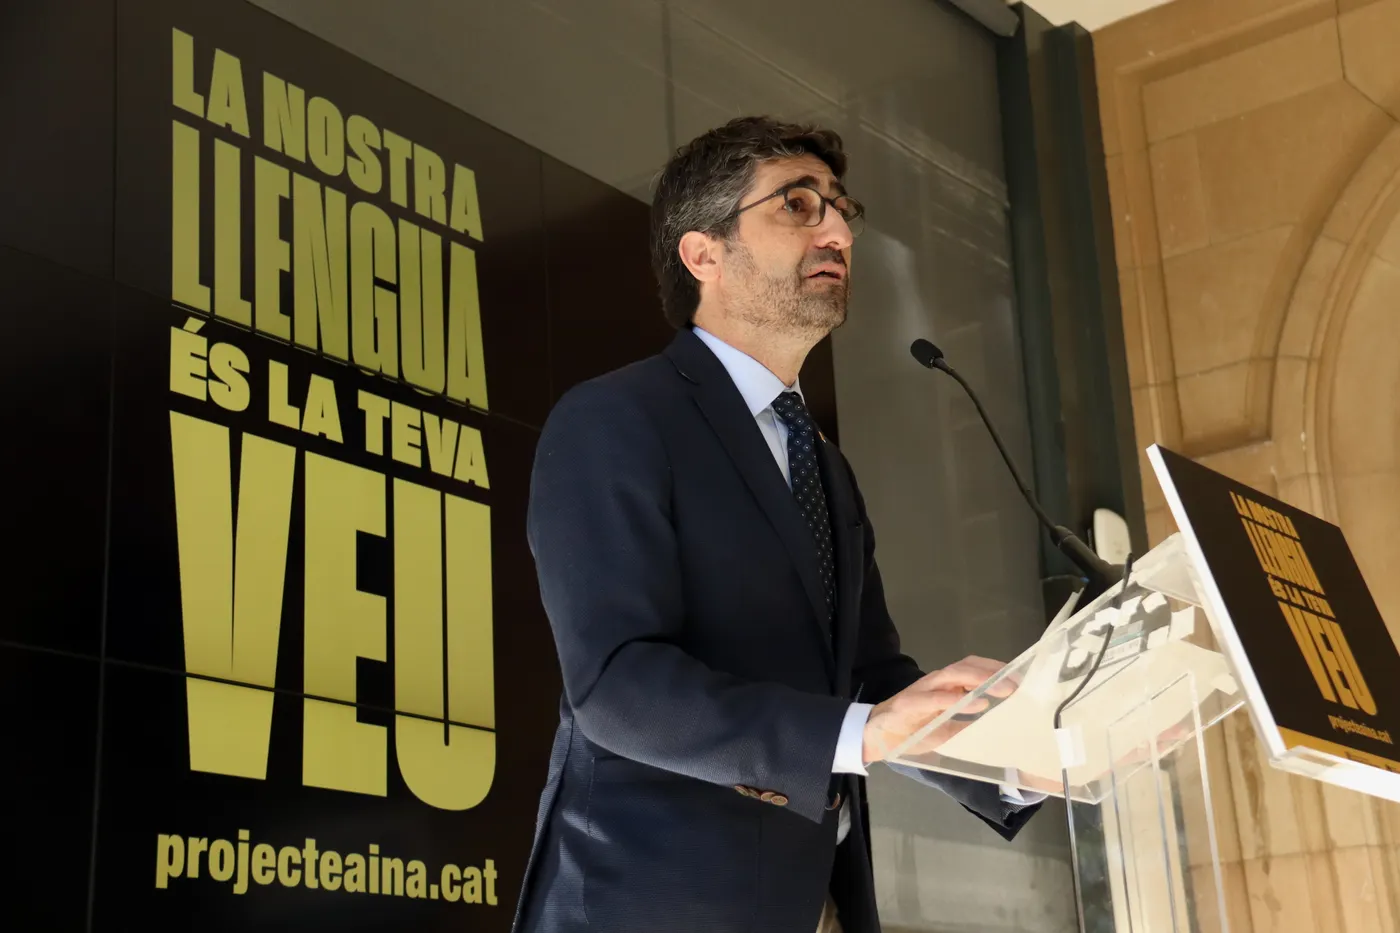
Foto d'Aina Martí / ACN.